如何从视频生成提示词:一份实用指南
学习如何把一段参考视频拆解成可复用的 AI 提示词:从场景、运动、镜头、风格到音频线索,而不是假装还原某个隐藏的原始提示词。
TL;DR:你要重建一个可用提示词,而不是找回隐藏原文
如果你想知道如何从视频生成提示词,最实用的答案是:先描述视频里实际出现的内容,再把这些观察整理成结构化信息,最后写成能指导新一轮 AI 视频生成的提示词。除非创作者主动公开,否则一段成片通常不会暴露它背后的精确原始提示词。
可靠的流程是把视频拆成场景,记录主体、动作、镜头、光线、风格、运动、节奏和音频线索,再把这些笔记改写成适合目标模型的提示词。如果你不想从空白页开始,VideoBreakdown 可以帮你搭好这套结构。
视频转提示词是怎么工作的
视频转提示词本质上是一次重建。你不是在读取视频里某个隐藏文件,而是在把可见、可听的细节翻译成清楚的生成指令。
一个有用的视频提示词应该回答几个具体问题:
- 主要主体是谁,或是什么?
- 画面随时间发生了什么?
- 场景发生在哪里?
- 镜头如何运动?
- 哪些光线、颜色和风格决定了整体观感?
- AI 模型应该避免什么?
所以,最好的结果通常不是一句话,而是一组结构化提示词。一句话可以概括主题,却很容易漏掉运动、镜头顺序、转场和负面提示词。
写提示词前应该捕捉哪些信息
先从可观察的细节开始。不要猜测原始镜头、镜头焦段、seed、私有模型参数或创作者工作流,除非这些信息在视频里可见,或者已经被公开说明。
主体和动作
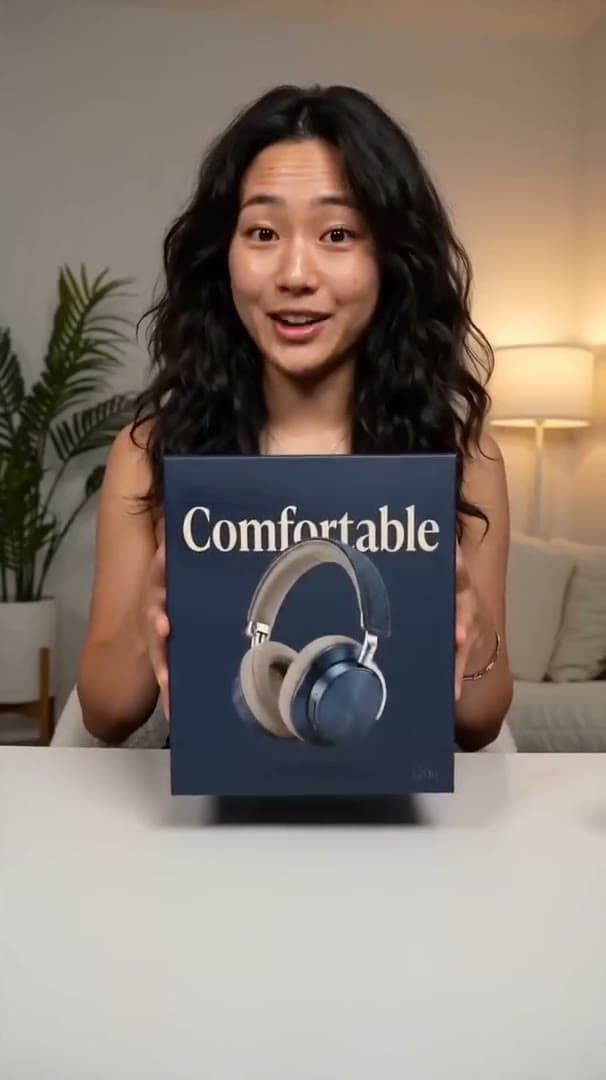
先写下主要主体,再描述动作。比如,“一位创作者在桌前拿着无线耳机”比“科技测评风格”更有用,因为它给了模型明确的主体和行为。
只有在次要动作真的影响结果时才加入。一个产品演示可能包括:手拿起产品、控制按键特写、最后的产品主画面。一个旅行短视频可能包括:行走动作、转身看向镜头、地点揭示。
场景、镜头和光线
接着描述环境,以及观众是如何看到它的。好的视频提示词会说明镜头是特写、俯拍、手持 vlog、低机位跟拍,还是广角建立镜头。
光线也很重要,因为它往往决定成片的情绪。记录参考视频使用的是柔和棚拍光、明亮户外日光、霓虹夜景、温暖窗光,还是高反差电影阴影。
运动、节奏和音频
很多弱 AI 视频提示词的问题在于,它们只描述了一张静态图。视频需要时间维度。你要捕捉主体运动、镜头运动、转场、速度、节奏,以及画面是否应该停在一个稳定的最终帧。
即使目标模型不能直接生成音频,音频线索也有价值。像“安静房间氛围和细微产品操作声”这样的说明,仍然能帮助你控制剪辑节奏和画面 pacing。
输出约束
生成前先决定格式:画面比例、时长、发布平台、模型风格、提示词长度,以及是否需要负面提示词。竖屏社交短片、16:9 产品演示和逐镜头电影化序列,需要的是不同结构。
如何一步步从视频得到提示词
无论你是手动分析,还是使用 video to prompt 工具,都可以按下面的流程来。
第 1 步:选择一段短参考视频
尽量使用聚焦的短片段,而不是一整条长视频。10 到 30 秒的参考片段通常比包含许多无关场景的完整视频更容易准确描述。
如果你使用的是他人的视频,请确认你有权分析并把它作为参考。除非隐私条款和你的使用场景匹配,不要把私人、受限、保密或权利敏感的视频上传到工具里。
第 2 步:把视频拆成场景笔记
先完整看一遍,不急着写。第二遍再在重要镜头处暂停,只记录你确实能观察到的内容。
可以使用这套笔记结构:
- 场景:这个镜头里发生了什么
- 主体:出现了谁,或什么物体
- 动作:随时间发生了哪些变化
- 镜头:角度、距离、运动和构图
- 光线:亮度、方向、色彩和反差
- 风格:写实、电影感、vlog、产品广告、动画、纪录片,或其他清晰风格
- 运动:主体运动、镜头运动、转场和节奏
- 音频:相关时记录口播、音乐、环境声或音效
这些笔记是视频和提示词之间的桥梁。之后修改提示词时,它们也能帮你看清到底漏了哪一层细节。
第 3 步:把笔记改写成提示词
现在,把笔记整理成一段清楚的提示词。如果你还在学习如何把视频转换成提示词,可以先使用固定框架:
生成一段 [时长]、[画面比例] 的视频,主体是 [主体],正在 [动作],场景位于 [环境]。
使用 [镜头角度和镜头运动]、[光线]、[视觉风格] 和 [运动/节奏]。
包含 [重要场景节拍或音频线索]。
避免 [负面提示词细节]。
下面是一个填好的例子:
生成一段 10 秒、16:9 的产品演示视频:一位创作者在干净桌面前介绍无线耳机。使用产品特写、轻微推近镜头、柔和棚拍光、真实手部动作和冷静的科技测评节奏。展示创作者拿起耳机、把耳机转向镜头,并以稳定的产品主画面收尾。避免手部变形、Logo 不可读、闪烁、刺眼阴影和随机跳切。这并不是参考视频背后的精确原始提示词,而是根据可见细节重建出来的实用替代提示词。
第 4 步:测试、对比、修改
先生成一个短结果,再和参考视频对比。重点看构图、主体动作、镜头运动、光线、节奏和镜头顺序有没有偏差。
一次只改一层。如果主体对了但镜头不对,就重写镜头那一句。如果结果像静态图,就加强运动和时间说明。如果它过度贴近了你并不拥有的参考内容,就保留有用结构,同时把场景改得更原创。
如何从视频链接生成提示词
如果你的搜索意图是“如何从视频链接生成提示词”,逻辑相同,只是输入从上传文件变成了公开视频 URL。
当视频公开且可以访问时,链接分析很方便。YouTube 参考视频可以从 YouTube 视频转提示词生成器 开始;普通参考视频可以使用主工具 视频转提示词生成器。
链接分析可能会因为视频私密、受限、删除、地区屏蔽或过长而失败。这时可以上传一段短剪辑,或把手动整理的场景笔记粘贴到工具里。保留备用路径很重要,因为目标是得到可用提示词,而不是依赖一个脆弱的 URL。
手动流程和使用 VideoBreakdown 的区别
手动写提示词给你最大的控制权。它适合那些需要谨慎创意判断、避开敏感细节,或有意改写源概念的场景。
VideoBreakdown 更适合快速获得结构化初稿。它能把场景笔记整理成提示词包,包含视觉摘要、场景拆解、镜头语言、光线、风格、运动和负面提示词建议。真正用于生产前,你仍然应该审阅结果。
可以用这个判断框架:
- 视频私密、敏感或法律关系复杂时,使用手动笔记。
- 需要从短参考视频快速得到初稿时,使用 VideoBreakdown。
- 已经有粗糙提示词,但想补强运动、镜头和风格细节时,使用 视频提示词优化器。
- 只需要一个聚焦场景,而不是完整视频拆解时,使用 场景提示词生成器。
- 想先看案例再分析具体视频时,浏览 免费 AI 视频提示词库。
一个视频转提示词框架示例
好的框架能让提示词保持可读,同时给模型足够明确的方向。
可以使用这个结构:
- 从最终任务开始:例如“生成一段 12 秒竖屏视频……”
- 写明主体和动作。
- 描述场景和视觉风格。
- 加入镜头运动和镜头顺序。
- 加入运动和节奏。
- 加入光线和色彩。
- 在有帮助时加入音频或剪辑线索。
- 加入负面提示词约束。
例如,一段旅行短视频参考可以改写成:
生成一段 12 秒竖屏旅行短视频:一位创作者在黄金时刻穿过狭窄的老城街道。先用广角建立镜头开场,切到从背后跟随的手持步行镜头,最后揭示创作者在一家小咖啡馆旁转身看向镜头。使用温暖阳光、自然运动模糊、纪录片式 vlog 节奏、柔和街道环境声和干净最终帧。避免颜色过饱和、建筑变形、面部不稳定、文字不可读和随机跳场。这个结构回答了“如何从视频提取提示词”背后的真正需求:它给你一个可重复的方法,把视频细节翻译成提示词语言。
常见错误
不要只写风格词。“电影感、爆款、高质量”不够。你还需要主体、场景、动作、镜头、光线和运动。
不要宣称自己还原了精确原始提示词,除非你确实拿到了原文。如果创作者没有公开,你写的是基于画面内容的替代提示词。
不要忽略运动。AI 视频提示词需要时间细节:什么在变化、变化多快、镜头如何开始和结束。
不要盲目复制受保护的创意元素。负责任地使用参考视频;必要时移除品牌敏感细节,并写出属于自己的场景方向。
不要一上来测试超长提示词。先生成短版本,对比结果,再逐步扩展。
FAQ
可以从视频里拿到精确的原始提示词吗?
通常不可以。成片一般不会暴露精确原始提示词。你可以根据可见、可听细节写出很强的替代提示词,但除非创作者公开了原文,否则不应把它说成原始提示词。
如何把视频转换成提示词?
把视频拆成场景,记录主体、动作、镜头、光线、风格、运动、节奏、音频和约束,然后把这些笔记改写成结构化 AI 视频提示词。
如何手动从视频提取提示词?
逐镜头暂停视频,只写可观察细节,把它们整理到提示词框架里,生成短测试,再根据不匹配的地方修改提示词。
如何从视频链接获取提示词?
使用公开视频 URL,并借助 VideoBreakdown 或 YouTube 视频转提示词生成器 这类支持链接的工具。如果链接私密或被屏蔽,可以上传短片段,或改用手动场景笔记。
好的 AI 视频提示词应该包含什么?
好的提示词通常包含主体、动作、场景、镜头运动、光线、视觉风格、运动、节奏、时长、画面比例、相关音频线索,以及负面提示词约束。
视频提示词提取是免费的吗?
VideoBreakdown 围绕免费公开流程设计,并带有使用限制。账号功能、历史记录、更高用量或团队工作流,可能取决于你使用时的产品设置。
上传视频做提示词提取安全吗?
请使用你拥有或有权分析的视频。除非你已经确认工具的隐私条款适合自己的场景,不要上传私人、保密、受限或权利敏感的视频。
生成的提示词可以商用吗?
生成文本本身可以使用,但你仍需对源视频、音乐、人物肖像、品牌以及最终生成结果相关的权利负责。拿不准时,把新场景写得更原创。
如果提示词生成结果不像参考视频怎么办?
把生成结果和参考视频对比,先修改最弱的一层。大多数偏差来自镜头方向太模糊、运动缺失、场景顺序不清,或风格词过于宽泛。
总结
学习如何从视频生成提示词,本质上是在学习如何把动态参考翻译成清楚的创作指令。先记录可观察细节,认真结构化,测试短结果,再有目的地修改。
想更快开始时,可以用 VideoBreakdown 把参考视频转换成结构化提示词包,然后根据你的模型、权利要求和创意目标调整最终措辞。